
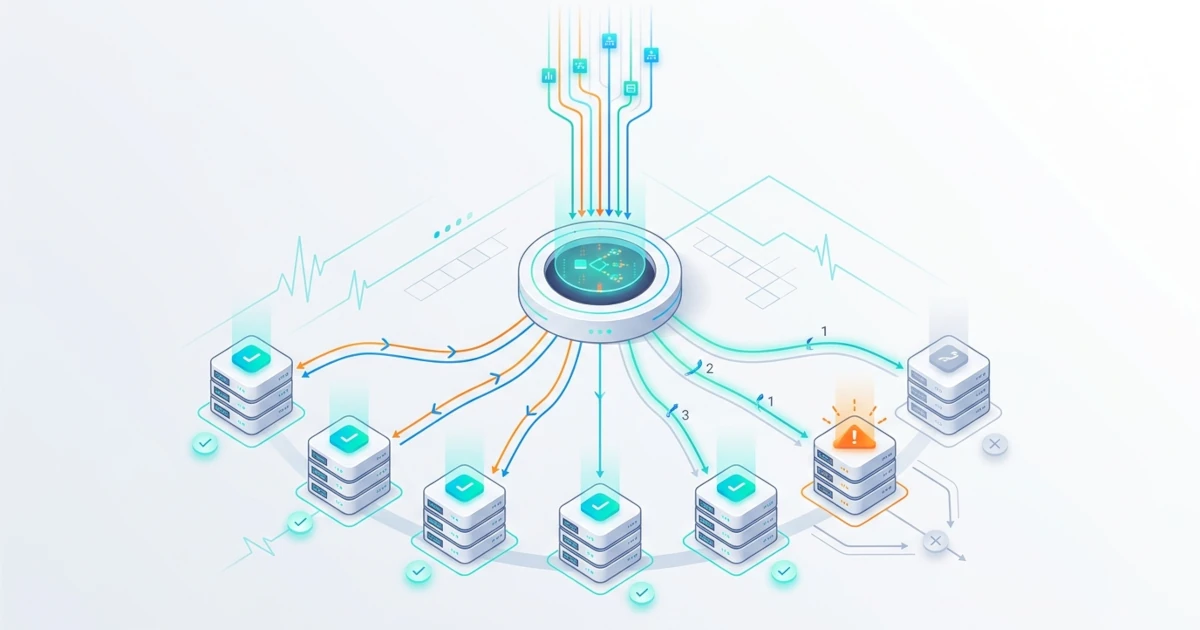
Pada Bab 12, backend aplikasi di balik location /app/ pada domain example.local hanya mengandalkan satu proses Python yang berjalan pada port 8080. Konfigurasi ini cukup untuk demonstrasi, tetapi rawan jika diterapkan di lingkungan produksi. Begitu proses backend tersebut crash, sedang direstart untuk deploy versi baru, atau kewalahan menerima traffic, seluruh domain langsung tidak dapat diakses meskipun Nginx sendiri masih berjalan normal di depannya. Satu backend berarti satu single point of failure, dan traffic yang terus bertambah cepat atau lambat akan melebihi kapasitas satu proses saja.
Bab ini melanjutkan topik reverse proxy yang telah dibahas pada Bagian 12.3.2, kali ini menggunakan lebih dari satu backend sekaligus. Kita akan menyusun upstream berisi beberapa instance backend, mendistribusikan request ke seluruh instance melalui load balancing, memilih algoritma yang sesuai kebutuhan, dan menambahkan health check sederhana agar Nginx mengetahui kapan harus berhenti mengirim traffic ke backend yang sedang bermasalah. Semua praktik menggunakan domain baru, app.example.local, mengikuti pola penambahan subdomain ke zone example.local yang telah dipraktikkan untuk blog.example.local pada Bagian 12.2.2.
15.1 Konsep Reverse Proxy dan Load Balancing
Sebagai reverse proxy, Nginx menerima request dari Visitor lalu meneruskannya ke backend yang memproses logika aplikasi, persis seperti yang telah dipraktikkan pada Bab 12. Load balancing adalah lapisan tambahan di atas kemampuan tersebut, yaitu kemampuan Nginx untuk mendistribusikan request yang masuk ke lebih dari satu backend yang menjalankan aplikasi identik, tidak hanya meneruskannya ke satu tujuan tetap. Kumpulan backend yang siap menerima distribusi ini disebut upstream atau backend pool, dan komponen yang memutuskan backend penerima setiap request disebut load balancer.
15.1.1 Dari Satu Backend ke Backend Pool
Dua alasan utama Sysadmin menggunakan load balancing di lapangan adalah skalabilitas dan ketersediaan. Dari sisi skalabilitas, satu server aplikasi memiliki batas kapasitas, baik karena CPU, memori, maupun jumlah koneksi yang sanggup ditangani sekaligus. Menambah backend baru ke upstream jauh lebih murah dan cepat dibandingkan menaikkan spesifikasi satu server tunggal, pola yang dikenal sebagai horizontal scaling. Dari sisi ketersediaan, selama masih ada minimal satu backend yang sehat di dalam pool, Nginx tetap dapat melayani Visitor meskipun salah satu backend lain sedang down atau sedang menjalani deploy, hal yang tidak mungkin dicapai jika backend hanya berjumlah satu.
Nginx open source, yang digunakan sepanjang series ini, telah menyediakan fitur load balancing dan passive health check secara bawaan melalui module ngx_http_upstream_module, tanpa perlu kompilasi khusus atau paket tambahan. Kemampuan lanjutan seperti active health check yang memeriksa backend secara berkala tanpa menunggu adanya request nyata dari Visitor akan dibahas pada Bagian 15.4.2, tetapi fitur tersebut eksklusif milik Nginx Plus, yaitu produk komersial dari perusahaan yang sama.
15.2 Nginx sebagai Reverse Proxy ke Aplikasi Backend
Bagian ini menyiapkan dua instance backend tiruan, lalu menghubungkan keduanya ke Nginx melalui satu blok upstream dan satu virtual host baru bernama app.example.local.
15.2.1 Menyiapkan Dua Instance Backend untuk Simulasi
Sama seperti demo pada Bagian 12.3.2, kita menggunakan HTTP server bawaan Python agar tidak perlu men-deploy aplikasi sungguhan hanya untuk mempelajari mekanisme load balancing. Bedanya, kali ini terdapat dua instance yang berjalan pada port berbeda, dan masing-masing sengaja diberi identitas berbeda pada halamannya agar mudah dibedakan melalui response yang diterima curl.
Langkah Praktik
- Siapkan direktori dan halaman untuk backend pertama.
mkdir -p ~/demo-backend-1 echo "Respons dari backend 1 (port 8080)" > ~/demo-backend-1/index.html - Siapkan direktori dan halaman untuk backend kedua.
mkdir -p ~/demo-backend-2 echo "Respons dari backend 2 (port 8081)" > ~/demo-backend-2/index.html - Jalankan kedua backend pada sesi tmux terpisah (Bab 3), agar keduanya tetap hidup meskipun kita berpindah-pindah terminal. Di sesi pertama:
Di sesi kedua:cd ~/demo-backend-1 python3 -m http.server 8080 --bind 127.0.0.1cd ~/demo-backend-2 python3 -m http.server 8081 --bind 127.0.0.1 - Dari sesi ketiga, pastikan keduanya benar-benar mendengarkan sebelum lanjut ke konfigurasi Nginx.
ss -tlnp | grep -E ':(8080|8081)'
Verifikasi dan Troubleshooting
- Jika salah satu port gagal terpasang karena sudah digunakan oleh proses lain, misalnya sisa proses demo dari Bab 12 yang masih berjalan pada port 8080, hentikan terlebih dahulu proses lama tersebut sebelum menjalankan proses yang baru. Cari PID proses melalui output
ss -tlnpdi atas, lalu hentikan menggunakan perintahkill. - Kedua backend sengaja dibiarkan hanya mendengarkan pada
127.0.0.1, bukan0.0.0.0, karena Visitor semestinya tidak pernah mengakses backend secara langsung. Satu-satunya jalur masuk yang benar adalah melalui Nginx pada port 80, sesuai dengan prinsip reverse proxy yang telah dibahas pada Bagian 12.3.2.
15.2.2 Konfigurasi upstream Block dan Virtual Host app.example.local
Langkah berikutnya adalah menghubungkan kedua backend tersebut ke Nginx melalui blok upstream, lalu membuat virtual host baru yang meneruskan semua request ke pool tersebut.
Langkah Praktik
- Tambahkan record DNS baru untuk
app.example.localpada zone fileexample.localyang telah kita kelola sejak Bab 9, mengikuti pola yang sama dengan recordblogpada Bagian 12.2.2.sudo nano /etc/bind/db.example.local
Naikkan nomor Serial padaapp IN A 192.168.1.20SOA, simpan, lalu validasi sintaksnya lebih dahulu sebelum reload, kebiasaan yang sudah kita terapkan sejak Bab 9.sudo named-checkzone example.local /etc/bind/db.example.local sudo systemctl reload bind9 - Buat file konfigurasi virtual host baru.
sudo nano /etc/nginx/sites-available/app.example.local - Isi dengan blok
upstreamdan blokserverberikut.
Blokupstream backend_app { server 127.0.0.1:8080; server 127.0.0.1:8081; } server { listen 80; listen [::]:80; server_name app.example.local; location / { proxy_pass http://backend_app; proxy_set_header Host $host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; } }upstreammendefinisikan nama pool,backend_app, beserta anggotanya. Nama ini kemudian digunakan langsung sebagai tujuan padaproxy_pass, menggantikan alamat backend tunggal sepertihttp://127.0.0.1:8080yang digunakan pada Bab 12. Empat directiveproxy_set_headertetap dipertahankan persis seperti pada Bagian 12.3.2 karena alasannya sama, yaitu backend tetap perlu mengetahui domain dan IP Visitor yang sebenarnya, tidak hanya melihat Nginx sebagai sumber dari seluruh request. - Aktifkan virtual host ini, uji sintaks, lalu terapkan.
sudo ln -s /etc/nginx/sites-available/app.example.local /etc/nginx/sites-enabled/ sudo nginx -t sudo systemctl reload nginx - Uji dari komputer lain dalam jaringan yang sama.
curl http://app.example.local
Verifikasi dan Troubleshooting
- Jika
nginx -tgagal dengan pesan"upstream" directive is not allowed here, kemungkinan besar blokupstreamtertulis di dalam blokserver { }. Blokupstreamharus berada sejajar dengan blokserver, bukan bersarang di dalamnya. - Untuk client yang belum menyinkronkan cache DNS, gunakan flag
--resolveseperti pada Bagian 12.2.2 agar pengujian tidak bergantung pada propagasi DNS.curl --resolve app.example.local:80:192.168.1.20 http://app.example.local/ - Response
502 Bad Gatewaypada tahap ini biasanya menandakan bahwa kedua backend belum berjalan. Ulangi pengecekanss -tlnpdari Bagian 15.2.1.
15.3 Load Balancing Dasar: Round Robin dan Least Connection
Konfigurasi pada Bagian 15.2.2 telah secara otomatis melakukan load balancing, hanya saja belum kita amati secara langsung dan belum kita bandingkan dengan algoritma lain. Bagian ini menguji perilaku dua algoritma yang paling umum digunakan, yaitu round robin sebagai default dan least connection sebagai alternatif untuk beban kerja yang tidak merata.
15.3.1 Round Robin sebagai Algoritma Default
Ketika blok upstream tidak menyertakan directive algoritma apa pun, seperti pada konfigurasi yang baru saja dibuat, Nginx menggunakan weighted round-robin secara default. Setiap anggota upstream memiliki weight bawaan bernilai 1 jika tidak ditentukan lain, dan request didistribusikan secara bergiliran serta proporsional terhadap nilai weight tersebut. Karena kedua backend sama-sama memiliki weight 1, request seharusnya berpindah secara bergantian antara backend 1 dan backend 2.
Langkah Praktik
- Kirim beberapa request berturut-turut, lalu perhatikan isi responsnya satu per satu.
for i in {1..6}; do curl -s http://app.example.local; echo; done
Hasilnya kurang lebih berselang-seling seperti berikut, meskipun Nginx tidak menjamin pola bergantian yang kaku pada setiap kondisi, misalnya saat salah satu backend baru saja mengalami kegagalan atau baru pulih dari status down.
Respons dari backend 1 (port 8080)
Respons dari backend 2 (port 8081)
Respons dari backend 1 (port 8080)
Respons dari backend 2 (port 8081)
Respons dari backend 1 (port 8080)
Respons dari backend 2 (port 8081)
Verifikasi dan Troubleshooting
- Jika seluruh response selalu berasal dari backend yang sama, periksa terlebih dahulu apakah backend lainnya benar-benar masih aktif melalui
ss -tlnp. Nginx tidak akan mengirim request ke backend yang connection-nya ditolak, sehingga hasil yang terlihat "tidak berimbang" sering kali sebenarnya terjadi karena satu backend sudah mati. - Weight dapat diatur secara eksplisit melalui parameter
weightpada barisserver, misalnyaserver 127.0.0.1:8080 weight=3;untuk backend dengan kapasitas lebih besar. Skema ini berguna jika kedua backend berjalan pada perangkat keras yang tidak setara, situasi yang cukup umum ditemui saat migrasi bertahap ke server baru.
15.3.2 Least Connection untuk Beban Request yang Tidak Merata
Round robin bekerja dengan baik selama setiap request membutuhkan waktu pemrosesan yang relatif sama. Masalah muncul jika durasi tiap request jauh berbeda, misalnya sebagian request hanya membaca data ringan sementara sebagian lain menjalankan proses berat seperti query database yang kompleks. Round robin tetap membagi rata jumlah request tanpa memedulikan backend mana yang sedang sibuk, sehingga backend yang kebetulan menerima beberapa request berat dapat terus-menerus dibebani request baru meskipun antreannya sudah penuh.
Least connection, yang diaktifkan melalui directive least_conn, mengatasi masalah ini dengan mengarahkan setiap request baru ke backend yang memiliki jumlah koneksi aktif paling sedikit pada saat itu, bukan sekadar bergiliran berdasarkan urutan. Mari kita buktikan perbedaannya melalui backend yang sengaja dibuat lambat.
Langkah Praktik
- Hentikan backend 1 (
Ctrl+Cpada sesi tmux-nya), lalu ganti dengan script Python kecil yang menunda setiap response selama 3 detik untuk mensimulasikan backend yang sedang memproses request berat.nano ~/demo-backend-1/slow_backend.pyfrom http.server import BaseHTTPRequestHandler, HTTPServer import time class SlowHandler(BaseHTTPRequestHandler): def do_GET(self): time.sleep(3) body = b"Respons dari backend 1 (lambat, port 8080)" self.send_response(200) self.send_header("Content-Length", str(len(body))) self.end_headers() self.wfile.write(body) HTTPServer(("127.0.0.1", 8080), SlowHandler).serve_forever()
Server bawaanpython3 ~/demo-backend-1/slow_backend.pyhttp.server, termasuk classHTTPServeryang digunakan oleh script ini, memproses satu request dalam satu waktu secara sekuensial, sehingga request yang menumpuk pada backend ini akan benar-benar mengantre, persis seperti efek yang ingin kita amati. - Gunakan terlebih dahulu konfigurasi round robin yang masih apa adanya dari Bagian 15.3.1, lalu kirim enam request sekaligus secara paralel dan ukur total waktunya.
Karena round robin tetap mengirim separuh dari enam request tersebut ke backend 1 yang lambat dan memprosesnya satu per satu, total waktunya akan didominasi oleh antrean pada backend tersebut, kira-kira sekitar tiga kali lipat dari 3 detik untuk request yang mengarah ke backend 1.time (for i in {1..6}; do curl -s -o /dev/null http://app.example.local & done; wait) - Tambahkan
least_conn;pada baris pertama blokupstream.sudo nano /etc/nginx/sites-available/app.example.localupstream backend_app { least_conn; server 127.0.0.1:8080; server 127.0.0.1:8081; } - Terapkan, lalu ulangi pengujian paralel yang sama.
Begitu request pertama diarahkan ke backend 1 dan backend tersebut sedang menahan satu koneksi aktif selama 3 detik, Nginx akan lebih memilih backend 2 yang koneksi aktifnya lebih sedikit untuk request-request berikutnya. Total waktu eksekusi seharusnya jauh lebih singkat dibandingkan hasil round robin pada langkah kedua.sudo nginx -t sudo systemctl reload nginx time (for i in {1..6}; do curl -s -o /dev/null http://app.example.local & done; wait)
Verifikasi dan Troubleshooting
- Penghitungan koneksi aktif untuk
least_conndilakukan per worker process Nginx, bukan gabungan seluruh worker, kecuali blokupstreammenggunakan directivezoneuntuk berbagi state lintas worker. Pada server produksi denganworker_processeslebih dari satu (nilai default padanginx.confadalahauto, mengikuti jumlah core CPU), efek least_conn dapat terasa kurang presisi dibandingkan demo satu-VM kecil ini karena setiap worker mengambil keputusan masing-masing berdasarkan koneksi yang terpantau olehnya. - Setelah selesai bereksperimen, hentikan
slow_backend.pydan jalankan kembali backend 1 versi normal dari Bagian 15.2.1 sebelum melanjutkan ke bagian berikutnya, agar pengujian health check tidak tercampur dengan simulasi backend lambat ini.cd ~/demo-backend-1 python3 -m http.server 8080 --bind 127.0.0.1
Ringkasan cepat berikut membantu memutuskan algoritma mana yang lebih relevan sesuai karakteristik aplikasi yang ada di belakang Nginx.
| Aspek | Round Robin (Weighted) | Least Connection |
|---|---|---|
| Directive | Tidak perlu directive, aktif secara default | least_conn; di dalam blok upstream |
| Dasar keputusan | Giliran berurutan, proporsional terhadap weight | Jumlah koneksi aktif paling sedikit saat itu juga |
| Paling cocok untuk | Request dengan durasi pemrosesan relatif seragam, misalnya static content atau API ringan | Request dengan durasi pemrosesan bervariasi, misalnya sebagian query database berat atau koneksi long-lived seperti WebSocket |
| Overhead di Nginx | Sangat ringan, sekadar penghitung giliran | Sedikit lebih berat karena melacak state koneksi aktif tiap backend secara terus-menerus |
15.4 Health Check Backend Sederhana
Load balancing saja belum cukup jika Nginx tetap mengirim request ke backend yang sudah mati. Bagian ini menambahkan mekanisme agar Nginx berhenti sementara dalam mengirim traffic ke backend yang gagal merespons, sampai backend tersebut terbukti pulih kembali.
15.4.1 Passive Health Check dengan max_fails dan fail_timeout
Nginx open source menyediakan passive health check melalui dua parameter opsional pada baris server di dalam blok upstream, yaitu max_fails dan fail_timeout. Disebut pasif karena Nginx tidak mengirim request percobaan sendiri ke backend, melainkan hanya mengamati hasil dari request Visitor yang sedang melintas. Parameter max_fails menentukan berapa kali percobaan gagal secara berturut-turut sebelum sebuah backend dianggap tidak tersedia, sedangkan fail_timeout berfungsi ganda, yaitu sebagai jendela waktu untuk menghitung kegagalan tersebut sekaligus durasi backend dianggap tidak tersedia sebelum dicoba kembali.
Langkah Praktik
- Tambahkan parameter
max_failsdanfail_timeoutpada kedua barisserverdi dalam upstream.sudo nano /etc/nginx/sites-available/app.example.localupstream backend_app { least_conn; server 127.0.0.1:8080 max_fails=2 fail_timeout=10s; server 127.0.0.1:8081 max_fails=2 fail_timeout=10s; } - Terapkan perubahan.
sudo nginx -t sudo systemctl reload nginx - Matikan backend 1 (
Ctrl+Cpada sesi tmux-nya) untuk mensimulasikan backend yang benar-benar down, lalu kirim beberapa request secara berturut-turut.
Beberapa request pertama kemungkinan tetap berhasil dan menampilkan response dari backend 2, berkat directivefor i in {1..5}; do curl -s http://app.example.local; echo; doneproxy_next_upstreamyang secara default telah aktif dengan nilaierror timeout. Artinya, begitu Nginx gagal terhubung ke backend 1 untuk satu request, Nginx secara otomatis mencoba backend berikutnya dalam pool yang sama tanpa Visitor sempat melihat error. Parametermax_failsdanfail_timeoutbekerja di atas mekanisme ini, membuat Nginx berhenti mencoba backend 1 begitu ambang kegagalannya tercapai, sehingga request berikutnya tidak perlu menunggu percobaan koneksi yang pasti gagal ke backend yang sudah diketahui mati. - Periksa error log untuk melihat kedua pesan ini secara langsung.
Cari baris yang menyebutkansudo tail -n 20 /var/log/nginx/error.logconnect() failedsaat percobaan koneksi ke backend 1 gagal, serta barisupstream server temporarily disabledsetelah ambangmax_failstercapai. - Tunggu lebih dari 10 detik sesuai dengan
fail_timeoutyang telah diatur, lalu jalankan kembali backend 1 seperti biasa, dan kirim beberapa request lagi untuk memastikan Nginx kembali mengirim traffic ke backend tersebut.cd ~/demo-backend-1 python3 -m http.server 8080 --bind 127.0.0.1for i in {1..6}; do curl -s http://app.example.local; echo; done
Verifikasi dan Troubleshooting
- Jika upstream hanya berisi satu backend saja,
max_failsdanfail_timeoutsecara otomatis diabaikan oleh Nginx, dan backend tunggal tersebut tidak akan pernah dianggap tidak tersedia meskipun terus-menerus mengalami kegagalan. Ini merupakan jebakan yang sering terlewat di lapangan, terutama saat Sysadmin menambahkan parameter ini pada upstream yang ternyata masih beranggotakan satu server saja, mengira fitur ini telah aktif padahal sebenarnya tidak memberikan pengaruh apa pun. - Jika kedua backend mati secara bersamaan, Visitor akan tetap menerima
502 Bad Gatewaykarena tidak ada satu pun backend sehat yang dapat dituju. Health check hanya membantu Nginx memilih backend yang sehat dari pilihan yang tersedia, bukan membuat backend yang mati menjadi hidup kembali.
15.4.2 Keterbatasan Passive Health Check dan Alternatif Active Health Check
Passive health check yang baru saja kita praktikkan memiliki satu kelemahan mendasar, yaitu Nginx baru mengetahui sebuah backend bermasalah setelah terdapat request Visitor sungguhan yang gagal melaluinya. Artinya, selalu ada setidaknya beberapa request nyata yang menjadi "korban" sebelum Nginx menandai backend tersebut tidak tersedia, meskipun berkat proxy_next_upstream sebagian besar Visitor tetap memperoleh response yang benar melalui mekanisme retry otomatis ke backend lain.
Active health check bekerja secara berbeda. Nginx mengirim request probe sendiri ke backend secara berkala, independen dari traffic Visitor, sehingga backend yang bermasalah dapat terdeteksi dan dikeluarkan dari pool sebelum sempat mengganggu pengalaman Visitor. Sayangnya, fitur ini eksklusif tersedia pada Nginx Plus, produk komersial dari F5, dan tidak ada pada Nginx open source yang kita gunakan sepanjang series ini. Untuk kebutuhan produksi yang membutuhkan active health check tanpa berlangganan Nginx Plus, opsi yang umum digunakan di lapangan antara lain menggunakan orchestrator seperti Docker atau Kubernetes yang memiliki mekanisme liveness probe sendiri di luar Nginx, atau membuat script pengecekan sederhana yang dijalankan melalui systemd timer (Bab 31) untuk memantau backend dan menyunting konfigurasi upstream secara terprogram saat dibutuhkan.
Untuk kebutuhan skala kecil hingga menengah yang menjadi fokus series ini, passive health check melalui max_fails dan fail_timeout biasanya sudah memadai, terutama karena konfigurasinya sederhana dan tidak menambah beban pada backend melalui request probe tambahan.
Sampai di tahap ini, domain app.example.local telah dilayani oleh dua backend sekaligus melalui satu blok upstream, menggunakan load balancing least connection yang lebih adil untuk beban kerja tidak merata, serta passive health check yang membuat Nginx secara otomatis menghindari backend yang sedang down. Bab 16 melengkapi seluruh virtual host yang telah kita bangun sejak Bab 12, termasuk app.example.local ini, dengan lapisan HTTPS melalui Let's Encrypt, agar komunikasi antara Visitor dan server tidak lagi berjalan polos melalui HTTP.