
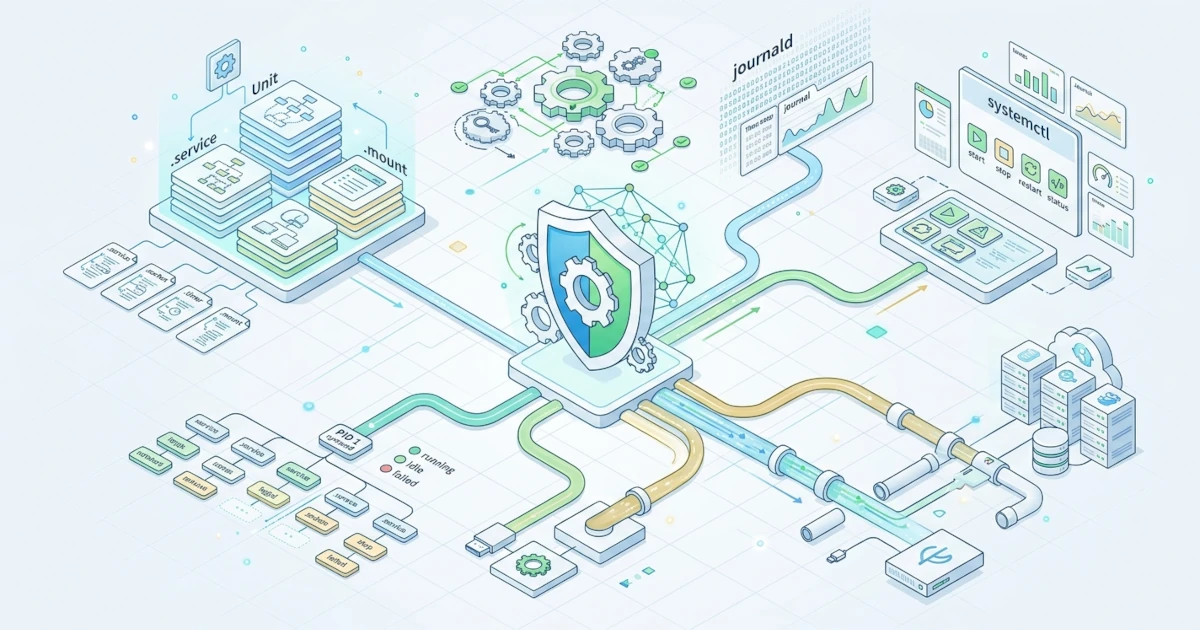
Server produksi biasanya menjalankan belasan service sekaligus, yaitu web server, database, aplikasi kustom milik Developer, hingga proses backup harian. Semua itu perlu start otomatis saat boot, restart sendiri kalau crash, dan berhenti dengan rapi saat server dimatikan. Tanpa satu orkestrator yang mengatur urutan dan ketergantungan antar service ini, Sysadmin bakal kewalahan menyalakan semuanya secara manual satu per satu setiap kali server reboot. Di sinilah systemd berperan sebagai init system yang menjalankan tugas itu, dan sejauh ini kita baru menyentuh permukaannya lewat systemctl status atau systemctl restart.
Bab ini membawa kita lebih dalam ke systemd, mulai dari review singkat cara kerjanya, lalu masuk ke keterampilan yang akan sering dipakai Sysadmin di lapangan: membuat unit service kustom untuk aplikasi milik tim sendiri, mengganti cron dengan systemd timer yang lebih andal, memahami target dan dependency antar service, dan menutup dengan topik yang cukup krusial di Ubuntu Server 26.04 LTS, yaitu migrasi penuh dari cgroup v1 ke cgroup v2.
5.1 Review Systemd dan systemctl
Systemd adalah proses pertama yang dijalankan kernel Linux saat boot, selalu dengan PID 1, dan bertanggung jawab menyalakan seluruh proses lain di sistem secara berurutan sesuai dependency yang sudah didefinisikan. Setiap hal yang dikelola systemd, baik itu service, mount point, device, maupun socket, direpresentasikan sebagai unit. Unit yang paling sering kita temui adalah service unit (berakhiran .service), tetapi ada juga timer unit (.timer), target unit (.target), mount unit (.mount), dan beberapa jenis lain yang lebih jarang disentuh Sysadmin sehari-hari.
Perintah utama untuk berinteraksi dengan systemd adalah systemctl. Sebelum masuk ke pembuatan unit kustom, ada baiknya kita tinjau kembali beberapa perintah yang paling sering dipakai untuk memeriksa kondisi sistem.
Verifikasi Cepat
systemctl status
systemctl list-units --type=service --state=running
systemctl list-unit-files --state=enabled
Perintah pertama menampilkan ringkasan kondisi systemd secara keseluruhan beserta target yang sedang aktif. Perintah kedua menampilkan seluruh service yang sedang berjalan, sangat berguna saat kita perlu tahu apa saja yang aktif di server tanpa harus mengingat nama setiap service satu per satu. Perintah ketiga menampilkan unit mana saja yang di-enable, artinya akan otomatis start setiap kali server boot.
Konfigurasi unit systemd tersebar di tiga lokasi dengan prioritas berbeda, yaitu /usr/lib/systemd/system/ untuk unit bawaan package, /etc/systemd/system/ untuk unit kustom atau override milik Sysadmin, dan /run/systemd/system/ untuk unit sementara yang dibuat runtime. Unit di /etc/systemd/system/ selalu punya prioritas lebih tinggi dibanding versi bawaan package, dan lokasi inilah yang akan kita pakai sepanjang Bab ini.
5.2 Membuat Unit Service Kustom
Cepat atau lambat, Developer di tim kita akan menitipkan aplikasi kustom, entah itu API backend, worker antrean, atau bot internal, yang perlu berjalan terus-menerus di server dan otomatis start saat boot. Menjalankannya lewat nohup atau di dalam sesi tmux yang kita bahas di Bab 3 bisa jadi solusi darurat, tapi tidak tahan reboot dan tidak punya mekanisme restart otomatis kalau proses tiba-tiba mati. Solusi yang tepat adalah membungkus aplikasi tersebut sebagai service unit systemd milik kita sendiri.
5.2.1 Anatomi Unit File ([Unit], [Service], [Install])
Sebuah service unit file berformat plain text dengan struktur mirip INI, terbagi ke dalam beberapa section. Tiga section yang wajib kita pahami adalah [Unit], [Service], dan [Install].
| Section | Fungsi | Directive Umum |
|---|---|---|
[Unit] | Metadata dan dependency terhadap unit lain | Description, After, Wants, Requires |
[Service] | Cara menjalankan dan mengelola proses | Type, ExecStart, Restart, User, WorkingDirectory |
[Install] | Perilaku saat unit di-enable | WantedBy, RequiredBy |
Di dalam [Service], directive Type menentukan bagaimana systemd menganggap proses sudah berhasil start. Nilai simple (default) berarti systemd langsung menganggap service aktif begitu ExecStart dijalankan, cocok untuk aplikasi yang tetap berjalan di foreground. Nilai forking dipakai untuk daemon lama bergaya Unix yang men-fork diri sendiri ke background. Nilai oneshot, yang akan kita pakai di bagian timer nanti, cocok untuk perintah yang berjalan sekali lalu selesai, bukan proses yang terus hidup.
Directive Restart adalah salah satu alasan utama kenapa systemd unggul dibanding menjalankan aplikasi manual di tmux. Melalui konfigurasi Restart=on-failure, systemd otomatis menyalakan ulang proses yang crash tanpa campur tangan Sysadmin, dan RestartSec mengatur jeda sebelum percobaan restart berikutnya agar tidak membanjiri log dengan restart loop yang terlalu cepat.
5.2.2 Membuat Service untuk Aplikasi Sendiri
Mari praktikkan langsung dengan skenario umum: Developer menitipkan sebuah aplikasi Python sederhana yang perlu berjalan sebagai service, bukan sebagai contoh web framework spesifik, sengaja dibuat generik agar polanya bisa kita terapkan ke aplikasi apa pun (Node.js, Go binary, atau bahasa lain) dengan menyesuaikan ExecStart.
Langkah Praktik
- Pastikan aplikasi punya user sistem tersendiri, jangan jalankan sebagai
root. Prinsip ini konsisten dengan least privilege yang akan kita bahas lebih formal di Bab 34.sudo useradd --system --no-create-home --shell /usr/sbin/nologin myapp - Letakkan kode aplikasi di direktori khusus, misalnya
/opt/myapp, dan pastikan kepemilikannya sesuai dengan user tadi.sudo chown -R myapp:myapp /opt/myapp - Buat file unit baru di
/etc/systemd/system/.sudo nano /etc/systemd/system/myapp.service - Isi dengan konfigurasi berikut, sesuaikan
ExecStartdengan cara aplikasi sebenarnya dijalankan.[Unit] Description=Aplikasi Internal Myapp After=network-online.target Wants=network-online.target [Service] Type=simple User=myapp Group=myapp WorkingDirectory=/opt/myapp ExecStart=/usr/bin/python3 /opt/myapp/main.py Restart=on-failure RestartSec=5 [Install] WantedBy=multi-user.target - Beri tahu systemd bahwa ada unit file baru yang perlu dibaca ulang. Langkah ini wajib dilakukan setiap kali kita menambah atau mengubah file unit secara manual.
sudo systemctl daemon-reload - Enable service agar otomatis start saat boot, lalu jalankan sekarang juga dengan satu perintah menggunakan flag
--now.sudo systemctl enable --now myapp.service
Verifikasi dan Troubleshooting
- Periksa status service, termasuk beberapa baris log terakhir langsung dari output.
systemctl status myapp.service - Untuk melihat log lengkap aplikasi, gunakan
journalctlyang secara otomatis menangkap stdout dan stderr dari service systemd tanpa perlu konfigurasi logging tambahan.journalctl -u myapp.service -f - Jika status menunjukkan
failed, penyebab paling umum di lapangan adalah pathExecStartyang salah, permission direktori kerja yang tidak sesuai denganUseryang didefinisikan, atau dependency seperti package Python yang belum terpasang secara sistem-wide. Baca pesanjournalctl -u myapp.servicebaris demi baris, systemd biasanya cukup jelas menyebutkan exit code dan alasannya. - Kesalahan yang sering ditemui pemula: lupa menjalankan
daemon-reloadsetelah mengedit file unit. Systemd tidak otomatis mendeteksi perubahan file, sehinggasystemctl restarttanpadaemon-reloadsebelumnya tetap memakai konfigurasi lama yang ada di memori.
5.3 Systemd Timer sebagai Pengganti Cron
Cron sudah melayani administrasi Linux selama puluhan tahun, dan tetap valid untuk kebutuhan sederhana. Tapi begitu kita butuh logging yang terintegrasi, kemampuan menjalankan ulang job yang terlewat karena server mati saat jadwalnya tiba, atau kontrol dependency terhadap service lain, systemd timer menawarkan pendekatan yang lebih modern dan lebih mudah di-debug. Semua log timer otomatis masuk ke journalctl, sama seperti service biasa, tanpa perlu redirect manual ke file log terpisah seperti kebiasaan lama di crontab.
5.3.1 .timer dan .service Pair
Systemd timer selalu bekerja berpasangan dengan sebuah service. Timer unit (.timer) hanya bertugas menentukan kapan, sedangkan pekerjaan sebenarnya tetap didefinisikan di service unit (.service) terpisah dengan Type=oneshot, karena job ini dijalankan sekali per jadwal lalu selesai, bukan proses yang hidup terus-menerus.
Mari praktikkan dengan skenario umum: menjadwalkan skrip backup harian, topik yang akan kita perdalam lagi di Bab 35.
Langkah Praktik
- Buat service unit untuk pekerjaan backup. Perhatikan
Type=oneshot, berbeda dari service aplikasi yang terus berjalan di bagian sebelumnya.sudo nano /etc/systemd/system/backup-harian.service[Unit] Description=Backup Harian Direktori Data [Service] Type=oneshot ExecStart=/usr/local/bin/backup-harian.sh - Buat timer unit dengan nama dasar yang sama persis, agar systemd otomatis mengaitkan keduanya tanpa perlu directive tambahan.
sudo nano /etc/systemd/system/backup-harian.timer[Unit] Description=Jadwal Backup Harian [Timer] OnCalendar=*-*-* 02:00:00 Persistent=true RandomizedDelaySec=300 [Install] WantedBy=timers.target - Reload systemd, lalu enable dan start timer-nya, bukan service-nya secara langsung. Service akan otomatis dipicu oleh timer sesuai jadwal.
sudo systemctl daemon-reload
sudo systemctl enable --now backup-harian.timer
Dua directive di bagian [Timer] patut mendapat perhatian khusus. Pengaturan Persistent=true membuat systemd mencatat kapan terakhir kali timer ini berhasil jalan, dan jika server ternyata mati saat jadwal seharusnya terpicu (misalnya maintenance dini hari), job ini akan langsung dijalankan begitu server kembali menyala. Ini adalah keunggulan yang tidak dimiliki cron biasa tanpa bantuan anacron tambahan. Sementara RandomizedDelaySec menambahkan jeda acak, berguna saat pola OnCalendar yang sama dipasang di banyak server sekaligus agar tidak semuanya membebani storage atau jaringan di detik yang persis sama.
Verifikasi dan Troubleshooting
- Lihat seluruh timer aktif beserta jadwal eksekusi berikutnya.
systemctl list-timers - Untuk menguji job tanpa menunggu jadwalnya tiba, trigger service-nya secara manual. Ini tidak memengaruhi jadwal timer yang sudah diatur.
sudo systemctl start backup-harian.service - Cek hasil eksekusi lewat log, sama seperti service pada umumnya.
journalctl -u backup-harian.service - Jika timer tidak pernah terpicu, penyebab paling sering adalah kesalahan sintaks pada
OnCalendar. Uji ekspresinya lebih dulu sebelum dipasang di production.systemd-analyze calendar "*-*-* 02:00:00" - Jika service gagal dengan status
faileddisertai pesanPermission deniedatauNo such file or directory, pastikan skrip/usr/local/bin/backup-harian.shbenar-benar ada dan sudah diberi izin eksekusi.sudo chmod +x /usr/local/bin/backup-harian.sh
5.4 Target dan Dependency antar Service
Target adalah unit khusus yang berfungsi sebagai titik sinkronisasi, mengelompokkan sekumpulan unit lain yang perlu aktif bersamaan. Konsepnya menggantikan runlevel di sistem init lama seperti SysV: multi-user.target setara dengan runlevel 3 (mode server tanpa GUI), sedangkan graphical.target setara runlevel 5. Server yang kita kelola sepanjang buku ini nyaris selalu boot ke multi-user.target, karena tidak butuh antarmuka grafis.
Kombinasi beberapa directive di section [Unit] membuat dependency antar unit menjadi sangat powerful, dan perbedaannya sering membingungkan Sysadmin baru.
| Directive | Arti |
|---|---|
After / Before | Hanya mengatur urutan start, tidak memaksa unit lain ikut aktif |
Wants | Mencoba mengaktifkan unit lain, tapi tetap lanjut walau unit itu gagal |
Requires | Mewajibkan unit lain aktif; jika gagal, unit kita ikut gagal |
Kombinasi yang paling umum dipakai di lapangan adalah After= dipasangkan dengan Wants=, persis seperti yang kita tulis di myapp.service tadi lewat network-online.target. Kombinasi ini masuk akal untuk kebanyakan aplikasi: kita ingin aplikasi menunggu jaringan siap dulu (After), dan mencoba memastikan jaringan aktif (Wants), tapi tidak sampai membuat seluruh service gagal total hanya karena target jaringan sedikit terlambat. Requires= baru masuk akal dipakai untuk dependency yang benar-benar fatal, misalnya aplikasi yang mustahil berjalan tanpa koneksi ke database lokal di server yang sama.
Langkah Praktik
- Lihat seluruh dependency yang dimiliki sebuah service, termasuk target induknya.
systemctl list-dependencies myapp.service - Untuk melihat arah sebaliknya, yaitu unit apa saja yang bergantung pada service tertentu, gunakan flag
--reverse.systemctl list-dependencies --reverse network-online.target - Cek target default yang dipakai server saat boot.
systemctl get-default
Verifikasi dan Troubleshooting
- Jika sebuah service gagal start saat boot tapi berhasil ketika di-start manual belakangan, curigai masalah urutan. Tambahkan
After=ke unit yang jadi dependency-nya, misalnyaAfter=postgresql.serviceuntuk aplikasi yang butuh database sudah siap terlebih dahulu. - Di lapangan, hindari kebiasaan memaksakan
Requires=ke hampir semua dependency hanya karena terasa "lebih aman". Terlalu banyakRequires=yang saling terkait membuat satu service kecil yang gagal bisa menjatuhkan rantai service lain yang sebenarnya tidak terlalu bergantung padanya. GunakanWants=sebagai default, dan naikkan keRequires=hanya saat dependency-nya memang benar-benar fatal.
5.5 Migrasi dari cgroup v1 ke cgroup v2
cgroup (control group) adalah fitur kernel Linux yang membatasi dan mengukur penggunaan resource, seperti CPU, memori, dan I/O, untuk sekumpulan proses. Systemd memanfaatkan cgroup secara intensif untuk mengisolasi setiap unit yang dijalankannya, dan inilah fondasi teknis di balik directive seperti MemoryMax atau CPUQuota yang bisa kita tambahkan ke section [Service] kapan pun kita perlu membatasi resource sebuah aplikasi.
5.5.1 Dampak Penghapusan cgroup v1 di 26.04
cgroup v1 memakai model hierarchy terpisah untuk setiap controller (CPU, memori, I/O masing-masing punya pohon hierarchy sendiri di /sys/fs/cgroup/), sedangkan cgroup v2 menyatukan semuanya ke dalam satu unified hierarchy. Model v2 ini sudah menjadi default di Ubuntu sejak beberapa rilis terakhir, dan seperti yang disinggung di Bab 1, Ubuntu Server 26.04 LTS mengambil langkah lebih jauh dengan menghapus dukungan cgroup v1 sepenuhnya, termasuk mode hybrid yang selama ini jadi jalan keluar bagi workload lama.
Dampaknya cukup nyata bagi Sysadmin yang mengelola server dengan riwayat panjang. Container runtime versi lama yang belum sepenuhnya mendukung cgroup v2, agen monitoring yang membaca path legacy seperti /sys/fs/cgroup/memory/memory.limit_in_bytes secara langsung alih-alih lewat API resmi, atau konfigurasi LXC lama yang mengandalkan devices controller gaya v1, berpotensi berhenti berfungsi begitu server diupgrade ke 26.04. Perubahan ini bukan sekadar penyesuaian kosmetik, melainkan penghapusan jalur kompatibilitas yang selama ini jadi jaring pengaman.
5.5.2 Memeriksa Kompatibilitas Workload Lama
Sebelum memigrasikan workload production yang sudah lama berjalan ke Ubuntu Server 26.04 LTS, audit dulu ketergantungannya terhadap cgroup v1. Langkah ini sebaiknya dilakukan di server staging, bukan langsung di production.
Langkah Praktik
- Periksa hierarchy cgroup yang sedang aktif di server. Filesystem bertipe
cgroup2fsmenandakan sistem sudah sepenuhnya memakai unified hierarchy v2.stat -fc %T /sys/fs/cgroup/ - Lihat daftar controller yang tersedia lewat cgroup v2 di server ini.
cat /sys/fs/cgroup/cgroup.controllers - Jika server menjalankan container runtime seperti Docker, pastikan versinya sudah mendukung cgroup v2 secara penuh, bukan cuma mode kompatibilitas.
docker info --format '{{.CgroupVersion}}' - Telusuri apakah ada skrip atau aplikasi internal yang membaca path legacy cgroup v1 secara langsung, alih-alih lewat tool resmi seperti
systemd-cglsatausystemd-cgtop.grep -rl "/sys/fs/cgroup/memory\|/sys/fs/cgroup/cpu," /opt/ /usr/local/bin/ 2>/dev/null
Verifikasi dan Troubleshooting
- Jika langkah pertama menampilkan
tmpfsalih-alihcgroup2fs, server yang sedang diperiksa kemungkinan masih memakai mode hybrid dari rilis Ubuntu sebelumnya, tandanya migrasi ke 26.04 perlu direncanakan lebih matang karena masih ada dependency v1 yang aktif. - Untuk container runtime yang ternyata belum siap, opsi paling aman adalah mengupgrade ke versi terbaru sebelum server ikut diupgrade, bukan menunda upgrade Ubuntu tanpa batas waktu. Menunda hanya menumpuk risiko, sebab dukungan resmi terhadap versi lama juga punya masa berlaku.
- Jujur soal risikonya ke tim: workload yang gagal diaudit sebelum migrasi berpotensi berhenti total begitu server sudah terlanjur diupgrade, dan rollback kernel bukan solusi yang realistis di lingkungan production. Audit di server staging jauh lebih murah dibanding insiden production tengah malam.
Sampai di sini, kita sudah punya bekal cukup untuk mengelola service secara mandiri lewat unit file kustom, menjadwalkan pekerjaan otomatis lewat timer, memahami dependency antar service lewat target, dan mengantisipasi dampak migrasi cgroup di 26.04. Bab 6 akan melanjutkan ke sisi lain administrasi server yang sama pentingnya, yaitu manajemen package di lingkungan server, mulai dari strategi repository hingga automasi update keamanan.